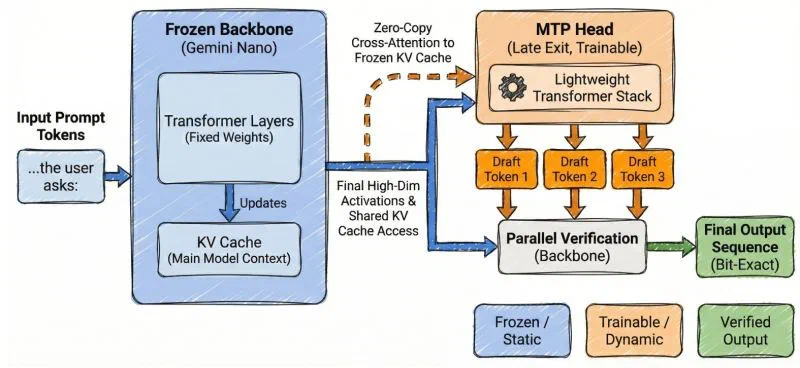
구글 Research가 최근 발표한 ‘Frozen Multi-Token Prediction’ 논문을 제 관점에서 한번 해석해 보았습니다.
구글의 AI 총체적 전략은 클라우드 중심의 거대 모델(Gemini Ultra/Pro)과 개인 기기 중심의 온디바이스 모델(Gemini Nano)을 양날의 검으로 삼는 ‘투트랙(Two-Track) 전략’으로 보이는데 Gemma4 가 배포되면서 좀 더 그런 행보들이 강화되는 것 같습니다.. 이번 논문은 그중에서도 ‘온디바이스(On-Device) AI 생태계의 강화’를 위한 노력으로 해석됩니다.
제 생각에는 구글이 실현하고자 하는 3대 전략적 강화 포인트는 아래와 같고 이 논문이 결을 같이 한다고 생각합니다.
- 하드웨어-소프트웨어 수직 계열화를 통한 ‘애플식 생태계(Lock-in)’ 강화
스마트폰 시장에서 하드웨어 스펙만으로 차별화를 주기는 이제 불가능에 가깝습니다. 구글은 자체 설계 칩셋(Tensor G5)과 독자적인 안드로이드 OS, 그리고 자체 AI 모델(Gemini Nano)을 모두 가진 유일한 기업입니다. 칩의 노는 연산 능력을 활용해 로컬 AI 속도를 최대 3배나 끌어올리는 기술적 묘수는 구글 외에는 구현하기 어렵습니다. 사용자에게 “최고의 초고속 로컬 AI를 쓰고 싶다면 픽셀 폰을 사라"는 하드웨어 판매 전략이자, 타사 스마트폰이 쉽게 따라올 수 없는 강력한 기술적 해자(Moat)를 파기 시작한 것입니다.
- 온디바이스 에이전트의 ‘경제성 및 확장성’ 강화 (개발자 락인)
AI 생태계에서 플랫폼 홀더가 되려면 외부 개발자들이 대거 참여해야 합니다. 하지만 기존에는 모바일 기기용 AI 앱을 만들려면 기기마다 최적화를 새로 해야 하거나, 비용이 많이 드는 클라우드 서버를 써야 했습니다. 구글은 이번에 메인 모델을 수정하지 않는 ‘Frozen(고정)’ 방식을 썼습니다. 그리고 이 가속화 엔진을 안드로이드 개발자 도구(LiteRT-LM, Firebase SDK)에 그대로 심어버렸습니다. 외부 개발자들은 추가 비용이나 복잡한 학습 과정 없이 구글 인프라 위에서 초고속 모바일 AI 앱을 뚝딱 만들 수 있게 된 것입니다. 개발자들을 구글 온디바이스 생태계로 끌어들이는 강력한 인센티브를 강화한 것입니다.
- 실시간 비서 서비스를 위한 ‘연산 가성비(Compute Economics)’ 극대화
앞으로의 AI는 사용자가 명령을 내릴 때만 작동하는 챗봇이 아니라, 백그라운드에서 실시간으로 화면을 보고, 통화를 번역하고, 알림을 요약해 주는 ‘상시 대기형 에이전트’가 되어야 합니다. 이때 배터리와 발열은 치명적인 제약입니다. ‘멀티 토큰 예측(MTP)’ 헤드를 결합해 연산 횟수 자체를 혁신적으로 줄인 것은, 스마트폰이 배터리 방전이나 발열 없이 24시간 내내 비서 AI를 백그라운드에서 구동할 수 있는 맷집을 길러준 것입니다. 진정한 의미의 ‘실시간 개인화 에이전트’ 시대를 열기 위한 기초 체력을 강화한 것으로 볼 수 있습니다.
거대한 기업에서 큰 전략에 조금만 신호일 수도 있고 전혀 관계가 없을수도 있지만 그럼에도 예전에 기술전략에서 구글을 바라보았던 관점에서 한번 살펴보았습니다. 보면 볼수록 대단한 회사인 것 같습니다.
#Google #AIStrategy #OnDeviceAI #TechStrategy #VerticalStrategy #RnD
(인용한 글 — Google Research)
Today on the blog we introduce a method to retrofit Multi-Token Prediction onto frozen production models, accelerating on-device inference without the inefficiencies of separate drafters.Learn more →https://goo.gle/43XvmOo